AIOps liefert die technische Grundlage.
AI Native Observability macht daraus ein kontextreiches, integriertes und kontrolliert automatisiertes Betriebsmodell.
Je hybrider die IT-Landschaft, desto mehr Telemetrie fällt an. Oft in einem Volumen, das isolierte Teams mit klassischen Monitoring-Werkzeugen nicht mehr sinnvoll auswerten können. Das Kernproblem liegt dabei selten in fehlenden Daten, sondern im fehlenden Kontext über Netzwerke, Infrastrukturen, Cloud und Applikationen hinweg. Genau hier setzt AI-Native Observability an.
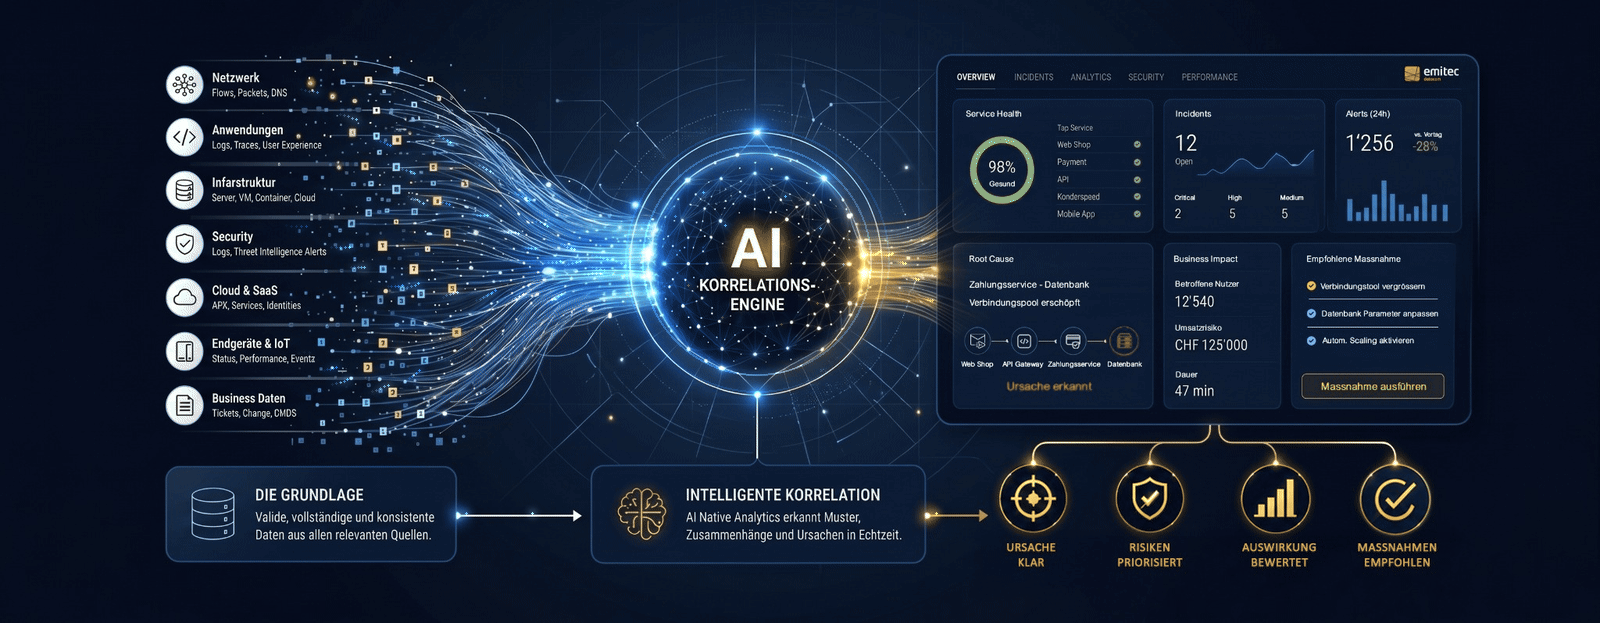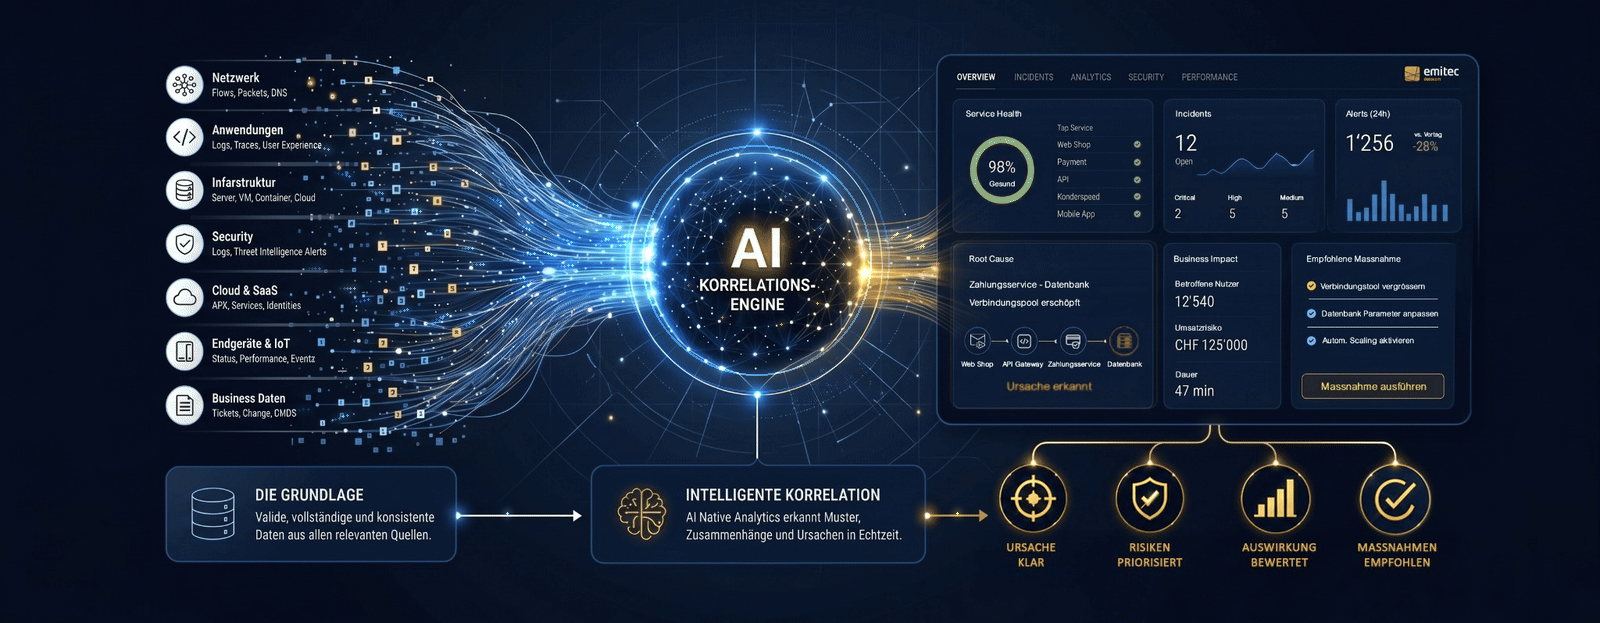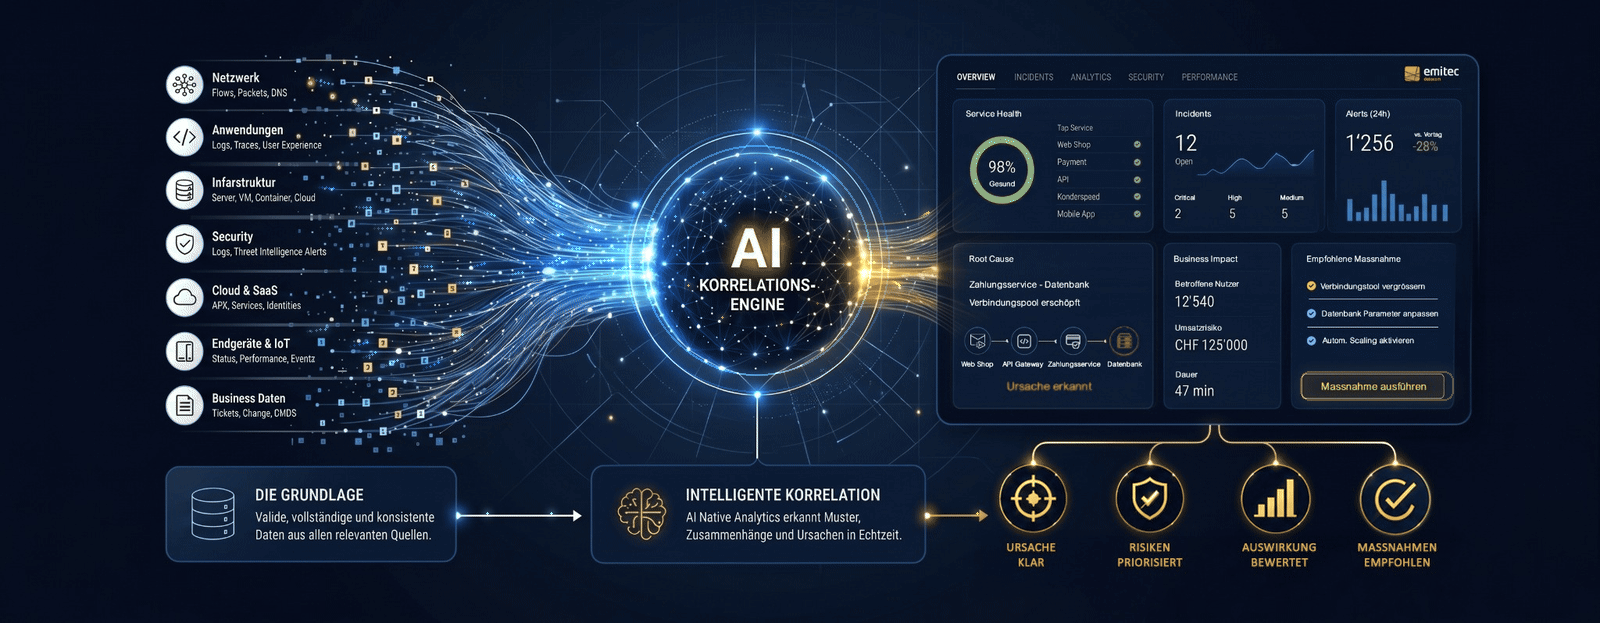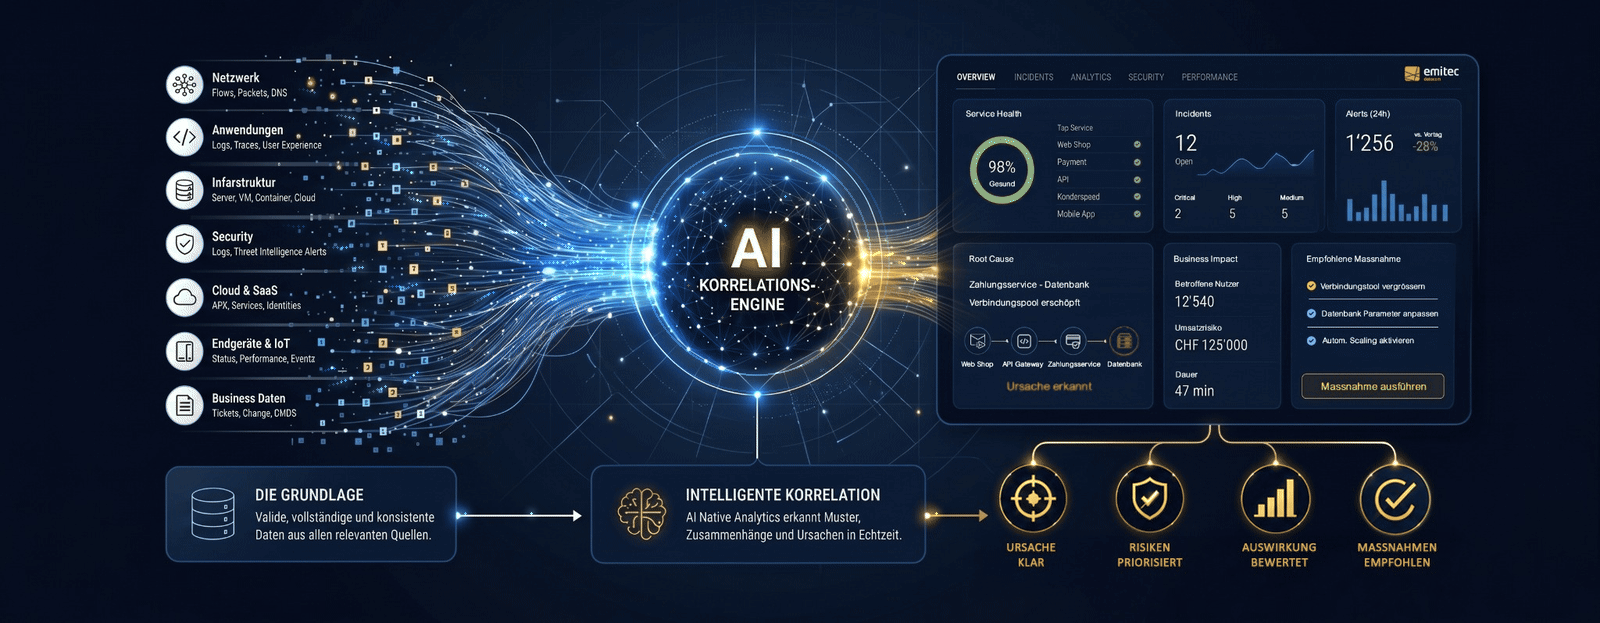
Der Ansatz bringt Betriebsdaten, Topologien und Service-Abhängigkeiten in einem dynamischen, kausalen Wissensgraphen zusammen, der sich laufend aktualisiert. Künstliche Intelligenz agiert hier nicht als reine Assistenzschicht, sondern ordnet Auswirkungen domänenübergreifend ein, entwickelt evidenzbasierte Hypothesen zur Fehlerursache und stösst innerhalb harter Policies klar begrenzte Aktionen an. AIOps liefert dafür historische, statistische Grundlagen. AI-Native Observability macht daraus ein kontextreiches, integriertes und kontrolliert automatisiertes Betriebsmodel
Grenzen des klassischen AIOps
:
Klassisches AIOps fokussiert sich primär darauf, das Alarmrauschen zu senken, Anomalien zu erkennen, Events zu korrelieren und bei der Ursachenanalyse zu unterstützen. AI-Native Observability baut darauf auf, geht aber durch die Integration umfassender Telemetriedaten über reines IT-Monitoring hinaus.
KI als Architekturfundament:
AI-Native Observability geht einen entscheidenden Schritt weiter. Die Künstliche Intelligenz prägt hier fundamentale Elemente wie das dynamische Datenmodell, den domänenübergreifenden Kontextaufbau, die Interaktion, die strukturierte Entscheidungsunterstützung und die operativen Workflows selbst.
Reduktion der Analysezeiten:
Der grösste messbare Zeitgewinn entsteht im Betrieb dort, wo manuelle Suchen und ständige Tool-Wechsel komplett wegfallen. Incidents sind von Anfang an mit dem nötigen technischen und geschäftlichen Kontext angereichert, was die Triage massgeblich beschleunigt.
Erweiterte Funktionalität :
Zusätzliche Funktionalität und betriebliche Tiefe entstehen aus der domänenübergreifenden Korrelation, Predictive Insights, assistierendem Copilot-Zugriff und technologisch kontrollierten Aktionen. Das System unterstützt proaktiv bei der Lösungsfindung und ermöglicht einen nahtlosen Übergang von der Erkenntnis zur Handlung.
Primärplattform & Kausaler Kern (inkl. MVP):
Definieren eines gemeinsam den Ziel-Use-Case und beweisen den operativen Nutzen messbar anhand eines Minimum Viable Products. Anschliessend etablieren wir einen kausalen Wissensgraphen, aktivieren push-basierte Telemetrie (wie gNMI) und setzen die Entity Resolution für den lückenlosen Topologie-Kontext auf.
Trennung von Ops und Security:
Operations und Security teilen sich zwar dieselbe hochwertige Telemetrie als fundierte Datenbasis, bleiben aber zwingend zwei eigenständige Disziplinen. Sie erfordern aus Compliance- und Governance-Gründen weiterhin den Einsatz eigener Prozesse, Playbooks und spezialisierter Systeme.
Als technologische Basis für AI Native Operations setzt Emitec auf Selector AI, eine AIOps-Plattform für Telemetrie-Korrelation, Unified Observability, Ursachenanalyse und Predictive Operations. Herstellerseitig verbindet sie Logs, Metriken, Konfigurationen und Topologien .in einem gemeinsamen Modell und ergänzt das um einen dynamischen Digital Twin sowie strukturierte Model Context Protocol (MCP) Server. Diese garantieren einen halluzinationsfreien Copilot-Zugriff auf die Topologiedaten. Über Conversational AIOps (ChatOps) können komplexe Topologie-Fragen oder Triage-Workflows direkt via MS Teams oder Slack in natürlicher Sprache ausgeführt werden. Selector AI liefert damit das technologische Fundament. Welche dieser Funktionen, Integrationen und Autonomiegrade für ein konkretes Projekt tatsächlich sinnvoll sind, klärt sich im jeweiligen Scope. Die Einführung eines AI-Native-Operations-Modells gelingt nicht durch die reine Beschaffung von Lizenzen. Emitec verantwortet die technische und prozessuale Integration über die gesamte Wirkungskette:
Primärplattform & Kausaler Kern (inkl. MVP)
Wir definieren gemeinsam den Ziel-Use-Case und beweisen den operativen Nutzen (z.B. eine signifikante MTTR-Reduktion) messbar anhand eines Minimum Viable Products. Im Anschluss etablieren wir Selector AI als zentralen kausalen Wissensgraphen, aktivieren moderne, push-basierte Telemetrie (wie gNMI) und setzen die fundamentale Entity Resolution für den lückenlosen Topologie-Kontext auf.
Ökosystem-Integration & ChatOps:
Bestehende Spezialwerkzeuge (wie DPI oder SIEM) bleiben als wertvolle Datenlieferanten erhalten und werden über offene Event-Streaming-Architekturen nahtlos angebunden, um Investitionen zu schützen. Parallel dazu aktivieren wir die MCP-Schnittstellen und Automatisierungs-Playbooks für dialoggestützte Ursachenanalysen (ChatOps) direkt im bestehenden ITSM-Workflow.
Konsolidierung & SNMP-Legacy-Ablösung:
Nach der erfolgreichen Übernahme aller relevanten Datenströme begleiten wir aktiv den gezielten Rückbau redundanter, isolierter Legacy-Monitoring-Silos. Diese konsequente Konsolidierung vereinfacht Ihre Betriebsabläufe massgeblich, senkt laufende Tool- und Lizenzkosten und verankert AI Native Operations endgültig als zukunftssicheres, nachhaltiges Betriebsmodell.
Selector AI ist eine AI-Native-Observability-Plattform, die Milliarden von Telemetriedaten in Echtzeit analysiert, Zusammenhänge erkennt und Root Causes automatisch identifiziert.
AI Native Observability macht daraus ein kontextreiches, integriertes und kontrolliert automatisiertes Betriebsmodell.
Monitoring beantwortet systemtechnische Fragen, die man bereits kennt – anhand fester Messgrössen und bekannter Schwellenwerte. Observability geht weiter: Reichhaltige Telemetrie und Kontext erlauben es, auch unbekannte Systemzustände zu untersuchen. Klassisches AIOps nutzt an dieser Stelle Statistik und Machine Learning, um Ereignisse zu bündeln, das Alarmrauschen (Alert Fatigue) zu senken und Incidents zu priorisieren.
AI-Native Observability reiht sich nicht als weitere Funktion in diese Kette ein, sondern verändert die Architektur. Die KI prägt das Daten- und Topologiemodell, die domänenübergreifende Korrelation, die Entscheidungsunterstützung und die operativen Workflows selbst.
|
Ansatz |
Schwerpunkt |
Operative Konsequenz |
|
Monitoring |
überwacht bekannte Zustände anhand fester Messgrössen und Schwellenwerte |
Teams werten Dashboards und Meldungen grösstenteils von Hand aus |
|
AIOps |
wertet Operations-Daten mit Statistik, Machine Learning und Automation aus |
Events werden gebündelt, korreliert, priorisiert und angereichert |
|
AI Native Operations |
KI prägt Datenmodell, Kontext, Diagnose und kontrollierte Aktionen |
Kausale Wissensgraphen berechnen den exakten Schadensradius (Blast Radius), unterdrücken unkorrelierte Folgealarme sofort und ermöglichen integrierte Workflows mit klar definierten Autonomiegraden. |
Grenze des Ansatzes
Ein nachträglich aufgesetztes Chat-Interface, eine generative Zusammenfassung oder eine isolierte Anomalieerkennung machen aus einem klassischen Monitoring-Tool noch keine Plattform für AI-Native Observability.
In der Praxis wird AIOps häufig mit verwandten Begriffen verwechselt, die jeweils eine andere Phase im IT-Lebenszyklus adressieren:
|
Konzept |
Fokus |
Ziel |
|
ITOps |
klassischer, oft manueller IT-Betrieb: Server, Netzwerke, Anwendungen am Laufen halten |
Stabilität durch menschliche Überwachung und feste Prozesse |
|
DevOps |
Zusammenarbeit von Entwicklung und Betrieb, kontinuierliche Integration/Bereitstellung (CI/CD) |
Schnellere, häufigere und zuverlässigere Software-Releases |
|
MLOps |
Entwicklung, Bereitstellung und Verwaltung von Machine-Learning-Modellen selbst |
Zuverlässiger Betrieb von KI-/ML-Anwendungen |
|
AIOps |
Einsatz von KI/ML, um den IT-Betrieb (ITOps) zu automatisieren und zu optimieren |
Schnellere Fehlerbehebung, weniger manueller Aufwand, proaktives Management |
Vereinfacht: ITOps ist die klassische Disziplin, die AIOps modernisiert. DevOps bestimmt, wie Software entsteht und ausgeliefert wird, AIOps dagegen, wie die daraus entstehende Infrastruktur im laufenden Betrieb überwacht und repariert wird. MLOps wiederum sorgt dafür, dass die KI-Modelle, die auch in AIOps- und in AI-Native-Operations-Plattformen zum Einsatz kommen, selbst zuverlässig laufen. AI Native Operations baut auf all dem auf, geht aber einen entscheidenden Schritt weiter. Die KI prägt hier nicht nur einzelne Funktionen, sondern das gesamte Betriebsmodell.
AI-Native Observability funktioniert nur als durchgehende Wirkungskette. Der Mehrwert entsteht dort, wo die Architektur konsequent auf Kontext ausgerichtet ist:
1. Telemetrie und Datenpipelines:
Metriken, Logs und Events allein reichen für Enterprise-Use-Cases selten aus. Erforderlich sind moderne, push-basierte Telemetrie (wie gNMI), Netzwerkpakete, Flows, Konfigurationen und synthetische Messungen, um den kritischen Servicepfad lückenlos abzudecken.
2. Entity Resolution und Kontext:
Über Entity Resolution und ein dynamisches Topologiemodell wird sichtbar, welche Komponenten zu welchem Business Service gehören. Ohne diesen Schritt bleibt jede Korrelation oberflächlich.
3. Kausale Einordnung:
Machine Learning und domänenspezifische Modelle ordnen Muster und Auswirkungen ein. Es muss nachvollziehbar bleiben, welche Signale eine Hypothese stützen. Korrelation allein belegt noch keine Kausalität.
4. Kontrollierte Aktionen:
Erkenntnisse fliessen in bestehende ITSM- oder Automatisierungsworkflows. Der Autonomiegrad wird streng reglementiert: von der Empfehlung bis zur limitierten Ausführung innerhalb freigegebener Runbooks.
5. Verifikation:
Erfolgsquoten, Rollbacks und manuelle Eingriffe fliessen als kontinuierliches Feedback in die Modelle zurück.
Die KI allein erzeugt noch keinen Mehrwert. Dieser entsteht erst aus dem Zusammenspiel von Daten, Kontext, Entscheidungslogik und kontrollierten Aktionen und lässt sich nur gegen eine Ausgangsbasis und anhand konkreter Betriebskennzahlen wirklich belegen.
|
Mehrwert |
Wie er entsteht |
Wie er gemessen werden kann |
|
Zeitersparnis |
weniger manuelle Suche und Übergaben dank Korrelation, Kontext und Incident Enrichment |
MTTA, MTTR, Mean Time to Innocence, Analysezeit pro Incident |
|
Mehr Funktionalität |
gemeinsames Datenmodell, Topologie, Copilot-Zugriff, Predictive Insights und integrierte Aktionen erweitern den Handlungsspielraum |
abgedeckte Use Cases, integrierte Quellen, Automatisierungsquote, Erfolgsquote |
|
Höhere Betriebsqualität |
dynamische Baselines und eine domänenübergreifende Sicht schärfen Priorisierung und Diagnose |
Alert-to-Incident Ratio, Eskalationsquote, wiederkehrende Incidents, SLO-Erfüllung |
|
Entlastete Fachkräfte |
repetitive Triage-, Such- und Dokumentationsschritte werden unterstützt oder übernommen |
manuelle Schritte pro Incident, Toil, Bereitschaftsaufwand, Zeit für Verbesserungsarbeit |
|
Stabilere Services |
schleichende Verschlechterungen zeigen sich früher im Servicekontext |
Verfügbarkeit, Error Budget Burn Rate, Nutzererfahrung, störungsbedingte Unterbrüche |
|
Wirtschaftlichkeit |
Tools und Workflows lassen sich konsolidieren, Betriebsaufwände sinken |
TCO, Toolkosten, Datenkosten, Implementierungsaufwand, vermiedener Aufwand |
Domänenübergreifende Incident-Triage:
Signale aus Netzwerk, Infrastruktur, Cloud und Anwendungen laufen auf einer gemeinsamen Zeitachse und im Servicekontext zusammen. Wer zuständig ist, lässt sich so schneller klären. Unnötige Eskalationen entfallen.
Priorisierte Ursachenhypothesen:
Statt einzelner Symptome bekommen Teams eine begründete Rangfolge möglicher Ursachen, wobei die zugrunde liegenden Signale und Abhängigkeiten für die fachliche Prüfung nachvollziehbar bleiben.
Automatisiertes Incident Enrichment:
Tickets werden automatisch mit betroffenen Services, relevanten Ereignissen, Topologie, früheren Änderungen und empfohlenen Prüfschritten angereichert – manuelle Erfassung und Rückfragen fallen weitgehend weg.
Predictive Operations und Kapazitätsplanung:
Wiederkehrende Muster und schleichende Verschlechterungen werden früher erkennbar, sodass Teams reagieren können, bevor Kapazitätsgrenzen oder Serviceeinschränkungen tatsächlich eintreten.
Change- und Impact-Analyse:
Ein aktuelles Abhängigkeitsmodell zeigt, welche Services, Standorte oder Nutzergruppen von einer geplanten Änderung betroffen sein könnten. Die tatsächliche Wirkung wird danach verifiziert.
Service Assurance und Nutzererfahrung:
Wenn technische Telemetrie mit SLI, SLO, syn.thetischen Tests oder End-User-Experience-Daten verknüpft wird, lässt sich klar priorisieren, welche technische Abweichung tatsächlich einen relevanten Service beeinträchtigt.
Die Einführung von AI-Native Observability scheitert in der Praxis selten an der Technologie, sondern an unklaren Architekturen und fehlender Datenqualität. Ein intelligentes Modell kann fehlerhafte Prozesse oder blinde Flecken in der Telemetrie nicht kompensieren. Vor der Skalierung müssen zwingend folgende architektonische und regulatorische Leitplanken (Governance) definiert sein:
Konkreter Ziel-Use-Case statt Technologie-Push:
Der Einstieg gelingt nicht über ein generisches Observability-Programm, sondern über die Lösung eines messbaren operativen Engpasses. Beispielsweise die Reduktion übermässiger Triage-Zeiten bei kritischen Applikationsausfällen.
Telemetrie & fundamentale Entity Resolution:
Metriken, Logs und Traces reichen allein oft nicht aus. Für eine belastbare Ursachenanalyse (Root Cause Analysis) müssen Netzwerkpakete, Flows, synthetische Tests und Konfigurationsdaten angebunden werden. Zwingend erforderlich ist die Entity Resolution: Ohne die fehlerfreie Zuordnung von Signalen zu einem Objekt im Topologie-Graphen (CMDB) bleibt jede KI-Korrelation wertlos.
Klare architektonische Systemrollen:
Es muss verbindlich feststehen, welche Plattform künftig welche Rolle übernimmt. Welche Applikation ist das System of Record (z. B. CMDB), welches das System of Insight (AI-Native Observability) und welches das System of Action (ITSM, Automatisierungs-Engine)?
Harte Autonomiegrade & Human-in-the-loop:
Das Betriebsmodell definiert, welche Aktionen das System selbstständig ausführen darf. Unkritische Diagnoseschritte (z. B. Ticket-Enrichment, Ping-Tests) lassen sich vollständig automatisieren. Bei risikoreichen Eingriffen (z. B. Port-Sperrungen, Rollbacks) braucht es zwingend Freigabeprozesse, Abbruchbedingungen und einen unveränderlichen Audit Trail.
Datenhoheit und Swiss Compliance:
Der Einsatz von KI erfordert volle Transparenz über die Datenverarbeitung. Für FINMA-regulierte Banken oder Betreiber kritischer Infrastrukturen (KRITIS) müssen Datenstandort (Swiss Cloud oder On-Premises) sowie explizite Opt-outs für das Training externer LLMs vertraglich und architektonisch abgesichert sein.
Der sinnvollste Einstieg in AI-Native Observability ist kein jahrelanges Transformationsprojekt, sondern ein Minimum Viable Product (MVP) direkt auf der Primärplattform. Emitec verbindet dabei die Perspektiven von IT Operations, Netzwerk und Architektur. Als technologische Engine (System of Insight) setzen wir auf Selector AI. Eine Plattform, die Telemetrie-Korrelation, Ursachenanalyse und Predictive Operations in einem dynamischen Wissensgraphen vereint.
Datenpipelines & Entity Resolution
Wir bewerten die Coverage der vorhandenen Telemetrie und schliessen blinde Flecken (z. B. durch TAPs, Packet Broker oder push-basierte Telemetrie). Die Rohdaten werden normalisiert und – als kritischer Erfolgsfaktor – über eine saubere Entity Resolution mit dem Topologie-Modell verknüpft.
Etablierung des kausalen Kerns (Selector AI)
Signale aus Netzwerken, Applikationen und Infrastruktur werden in das Datenmodell von Selector AI überführt. Statt isolierter Dashboards entsteht ein laufend aktualisierter Service-Kontext. Die KI beginnt, Zusammenhänge domänenübergreifend zu korrelieren und priorisierte Hypothesen zur Fehlerursache zu bilden.
Workflow-Integration & kontrollierte Aktionen
Im letzten Schritt wird die gewonnene Erkenntnis in Handlung überführt. Wir binden Ihre ITSM- und Automatisierungsworkflows an. Gemeinsam definieren wir Runbooks und legen die Autonomiegrade fest – von der assistiven Empfehlung für den 2nd-Level-Support bis hin zu freigegebenen, automatisierten Remediation-Schritten.
Assessment & Baseline-Definition
Wir definieren gemeinsam einen priorisierten Business Service und erfassen den Status quo. Wir legen die Baseline fest (z. B. aktuelle MTTR, Incident-Volumen, manuelle Triage-Zeit), an der sich das MVP am Ende wirtschaftlich und operativ messen lassen muss.
| Metrik | Definition & Zielsetzung | Operativer Nutzen |
| MTTA / MTTR Reduktion | Messbare Verkürzung der Zeit von der Störungserkennung bis zur Fehlerbehebung im definierten Use Case. | Höhere Service-Verfügbarkeit und Einhaltung von SLOs. |
| Mean Time to Innocence | Zeit, bis zweifelsfrei bewiesen ist, welches Team/Silo nicht für das Problem verantwortlich ist. | Massiver Rückgang von "Ping-Pong-Eskalationen" zwischen den Teams. |
| Alert-to-Incident Ratio | Reduktion von isolierten Einzelwarnungen (Alarmrauschen) zu wenigen, kontextualisierten Incidents. | Fokus auf kritische Business-Impacts statt auf Symptombekämpfung. |
| Automatisierungsquote | Anteil der Incidents, die automatisch mit Diagnosedaten (Enrichment) angereichert werden. | Direkte Entlastung von repetitiver Toil-Arbeit im IT-Betrieb. |
Emitec bringt die Perspektiven von IT Operations, Observability, Netzwerk und Security nahtlos zusammen. Der Ausgangspunkt für Ihr Projekt ist dabei immer die ganz konkrete Betriebsherausforderung und die exakt dafür nötige Datenbasis im Unternehmen – nicht einfach nur eine isolierte Produktfunktion. Durch diesen ganzheitlichen Blickwinkel stellen wir sicher, dass technologische Silos aufgebrochen werden und echte Mehrwerte für Ihren Betriebsalltag entstehen.
Strategische Analyse und Use-Case-Definition
Im ersten Schritt nehmen wir Ihre aktuelle Ausgangslage detailliert auf, identifizieren geschäftskritische Services und definieren klar priorisierte Use Cases.
Fundierte Bewertung der Dateninfrastruktur
Daraufhin bewerten wir die in Ihrem Unternehmen bereits vorhandene Telemetrie, bestehende Datenpipelines, Topologien und aktuelle Integrationen.
Massgeschneiderte Architektur- und Plattformplanung
Basierend auf den gewonnenen Erkenntnissen ordnen wir eine passende Lösungsarchitektur und die idealen Plattformfunktionen genau Ihren spezifischen Anforderungen zu.
Messbare Validierung (MVP)
Um den tatsächlichen operativen Mehrwert zu belegen, testen wir den Nutzen der Lösung (z.B. eine signifikante MTTR-Reduktion) in einem MVP gegen eine vorab definierte Baseline.
Nahtlose Prozessintegration und klare Governance
Wir binden die neuen Systeme direkt an Ihre bestehenden ITSM- und Operations-Workflows an, definieren klare Verantwortlichkeiten (Rollen) und legen verbindliche Automatisierungsgrenzen fest.
Etablierung von KPIs und kontinuierlicher Optimierung
Abschliessend bauen wir relevante Messgrössen, ein zukunftsfähiges Betriebsmodell und strukturierte Prozesse für die laufende Optimierung auf.
Zu AI-Native Observability
Nicht zwingend. Spezialisierte Tools (etwa für reines Netzwerk- oder Hardware-Monitoring) können weiterhin als wertvolle Rohdatenquelle dienen. ITSM-Plattformen wie ServiceNow bleiben in der Regel das System of Record. AI-Native Observability fungiert als System of Insight, das diese Datensilos aufbricht und übergreifend korreliert. Ob sich isolierte Legacy-Tools vollständig konsolidieren lassen, entscheidet sich im Rahmen des Architektur-Assessments anhand von Datenqualität und Funktionsabdeckung.
Metriken, Logs und Traces (MELT) allein reichen für Enterprise-Umgebungen selten aus. Für eine lückenlose, domänenübergreifende Kausalitätsanalyse müssen je nach Use Case oft Netzwerkpakete, Flows, API-Aufrufe, Konfigurationsänderungen und synthetische Tests (Service Assurance) integriert werden. Architektonisch zwingend ist zudem die Anbindung an die CMDB für eine fehlerfreie Entity Resolution (Zuordnung von Signalen zu einem Objekt im Topologie-Graphen).
Der Autonomiegrad wird über strenge Policies für jeden Use Case individuell festgelegt. Unkritische Diagnoseschritte (z. B. Ping-Tests) oder das Anreichern von Tickets (Incident Enrichment) lassen sich vollautomatisieren. Bei potenziell disruptiven Aktionen (z. B. automatisierte Rollbacks, Port-Sperrungen) greifen zwingende Freigabeprozesse (Human-in-the-Loop), harte Abbruchbedingungen und lückenlose Audit Trails.
Für FINMA-regulierte Unternehmen oder Betreiber kritischer Infrastrukturen (KRITIS) ist die Daten-Governance entscheidend. Es wird strikt zwischen lokalen, domänenspezifischen Machine-Learning-Modellen für die Operations-Daten und externen Large Language Models (LLMs) getrennt. Telemetriedaten können architektonisch so verarbeitet werden (On-Premises oder in der Swiss Cloud), dass Unternehmensdaten nicht unautorisiert für das Training globaler Modelle abliessen.
Emitec empfiehlt anstelle grossangelegter AIOps-Programme einen architekturgetriebenen MVP-Ansatz (Minimum Viable Product). Dabei wird ein priorisierter Use Case direkt an der Primärplattform (z. B. mit Selector AI als Engine) umgesetzt. Der Erfolg wird operativ gegen eine vorab definierte Baseline geprüft. Typische Metriken zur Erfolgsmessung sind eine messbare Reduktion der MTTR (Mean Time to Resolve), eine geringere Alert-to-Incident Ratio und die Reduktion des manuellen Triage-Aufwands.
CEO | Senior Consultant
+41 41 748 60 10
Entdecken Sie unsere gefragtesten Themen – mit einem Klick.
AI-Native SecOps erkennt Bedrohungen proaktiv und unterstützt Security-Teams mit intelligenter Automatisierung. So werden Risiken schneller und effizienter reduziert.
Unternehmen sammeln grosse Mengen an Netzwerkdaten. TAPs überwachen den Verkehr, und Packet-Broker filtern und bündeln die Daten. Dies part Kosten und verbessert die Datenerhebung.
Die Stabilität von Anwendungen beeinflusst die Produktivität. EUEM identifiziert frühzeitig Probleme und hilft, die Qualität der Anwendungen zu sichern.
Eine zuverlässige Lösung zur Überwachung der Verfügbarkeit von Applikationen und Services reduziert den Workload und schafft Kapazitäten für strategische IT-Projekte.