AIOps liefert die technische Grundlage.
AI Native Operations macht daraus ein kontextreiches, integriertes und kontrolliert automatisiertes Betriebsmodell.
Je hybrider die IT-Landschaft, desto mehr Telemetrie fällt an. Oft mehr, als einzelne Teams mit isolierten Monitoring-Werkzeugen noch sinnvoll auswerten können. Das eigentliche Problem liegt dabei selten in fehlenden Daten. Es fehlt an gemeinsamem Kontext, an belastbaren Prioritäten und an einem kontrollierten Weg von der Erkenntnis zur Handlung. Genau an diesem Punkt setzt AI Native Operations in der IT an.
Der Ansatz bringt Betriebsdaten, Topologien und Service-Abhängigkeiten in einem Modell zusammen, das sich laufend selbst aktualisiert. Künstliche Intelligenz übernimmt dabei mehr als nur das Aufspüren von Auffälligkeiten. Sie ordnet deren Auswirkungen ein, entwickelt nachvollziehbare Hypothesen zur Ursache und stösst klar begrenzte Aktionen an.
Für IT- und Operations-Teams heisst das konkret: Weniger Zeit für manuelle Korrelation, schnellere Entscheidungen und mehr Tiefe über Netzwerk, Infrastruktur, Cloud und Anwendungen und Business Services hinweg.
Klassisches
AIOps senkt Alarmrauschen,
erkennt Anomalien, korreliert Events und unterstützt bei der Ursachenanalyse.
AI Native Operations geht einen Schritt weiter. Die KI prägt hier das Datenmodell, den Kontextaufbau, die Interaktion, die Entscheidungsunterstützung und die operativen Workflows selbst.
Der grösste Zeitgewinn entsteht dort, wo manuelle Suche und Tool-Wechsel wegfallen und Incidents von Anfang an mit Kontext angereichert sind.
Zusätzliche Funktionalität kommt aus domänenübergreifender Korrelation, Predictive Insights, Copilot-Zugriff und kontrollierten Aktionen.
Ob sich der Nutzen wirklich einstellt, zeigt erst der Vergleich mit einer Baseline – etwa bei MTTA, MTTR, Mean Time to Innocence, SLO-Erfüllung oder manuellem Analyseaufwand.
Operations und Security teilen sich zwar die Telemetrie, bleiben aber zwei eigenständige Disziplinen mit eigenen Prozessen und Systemen.
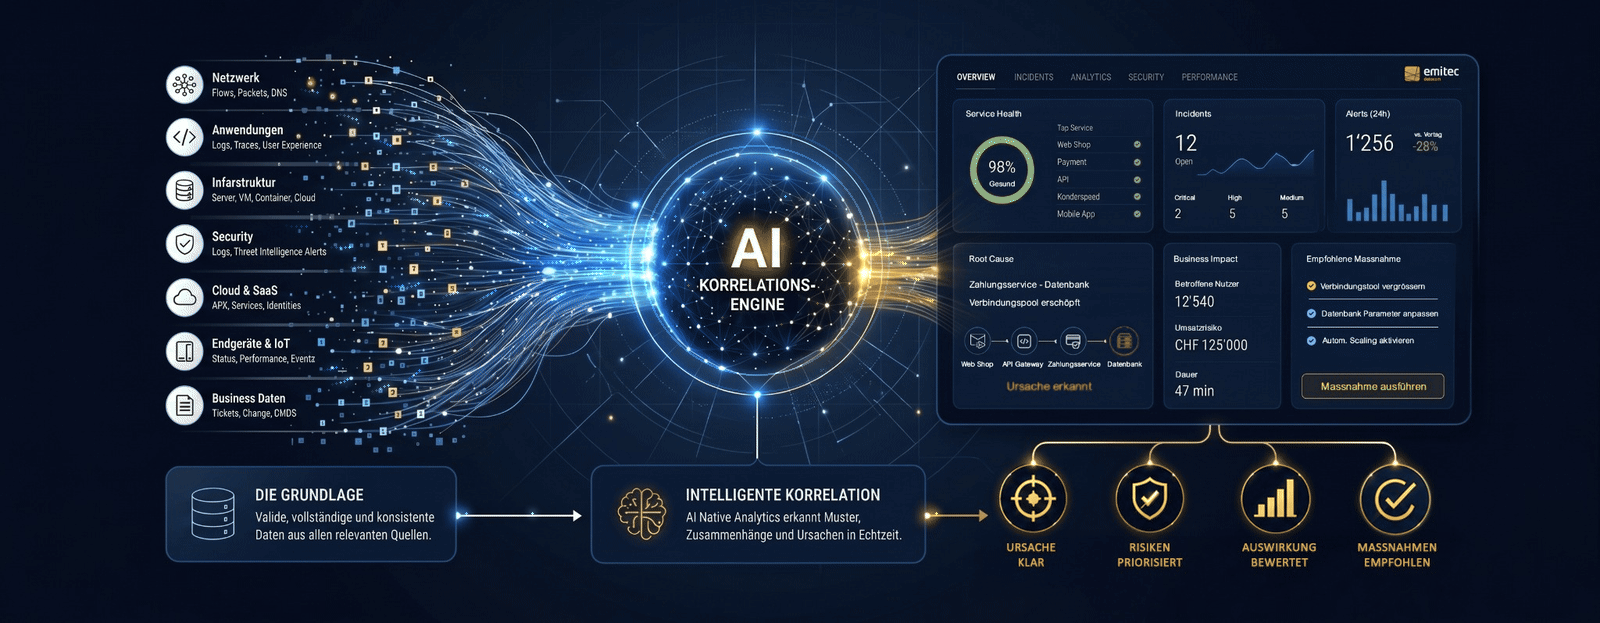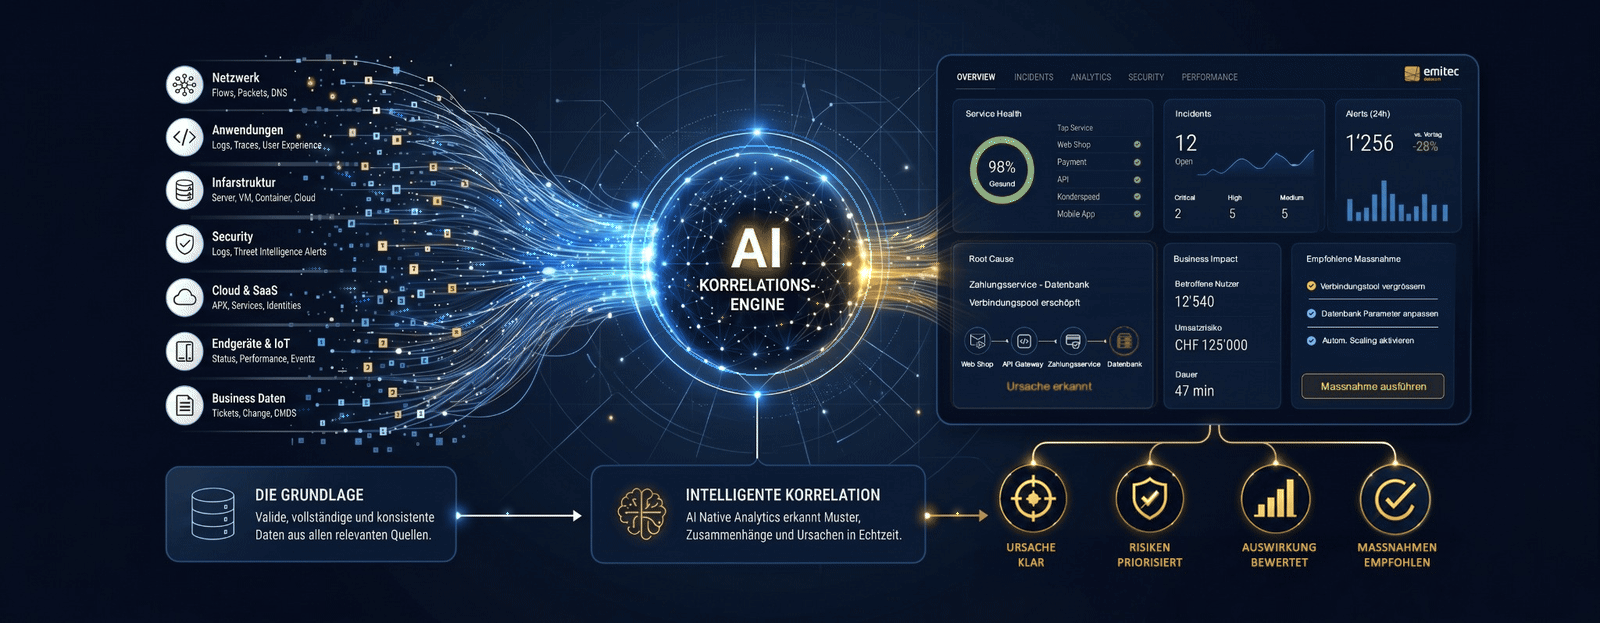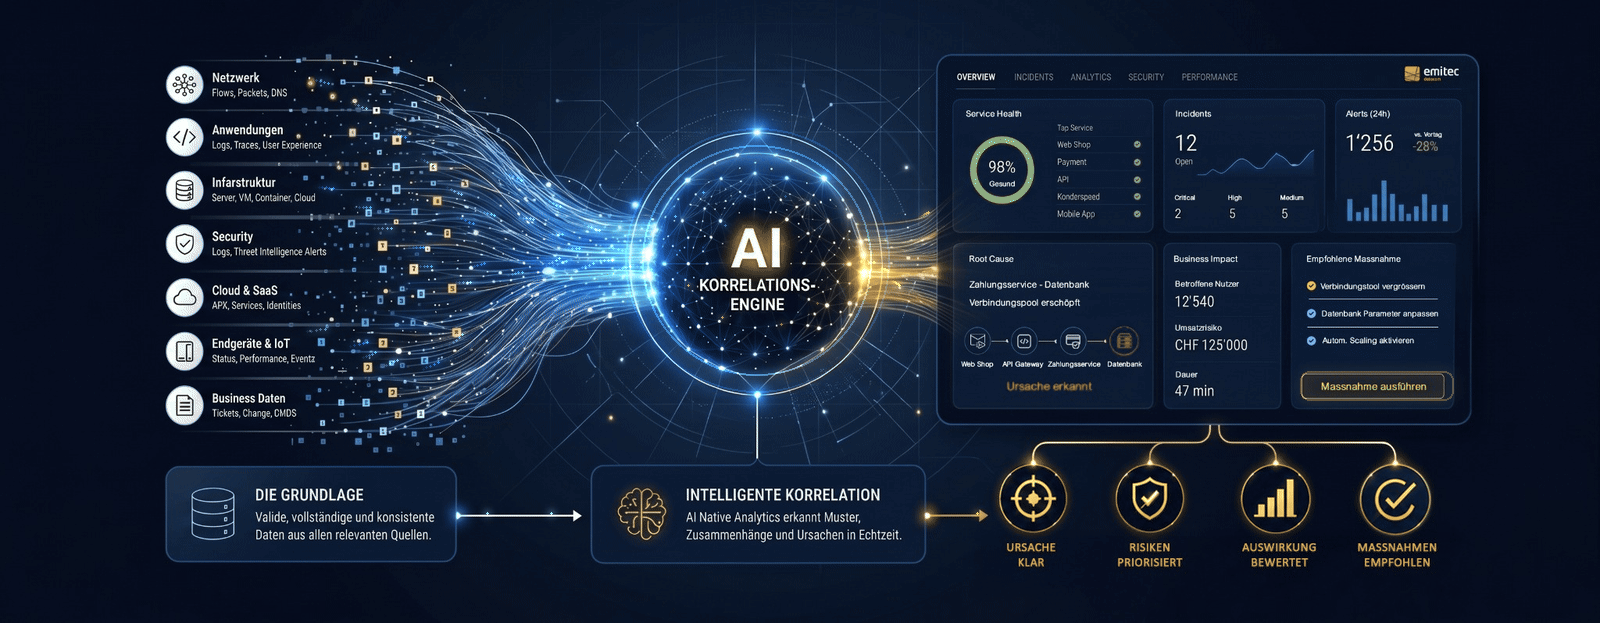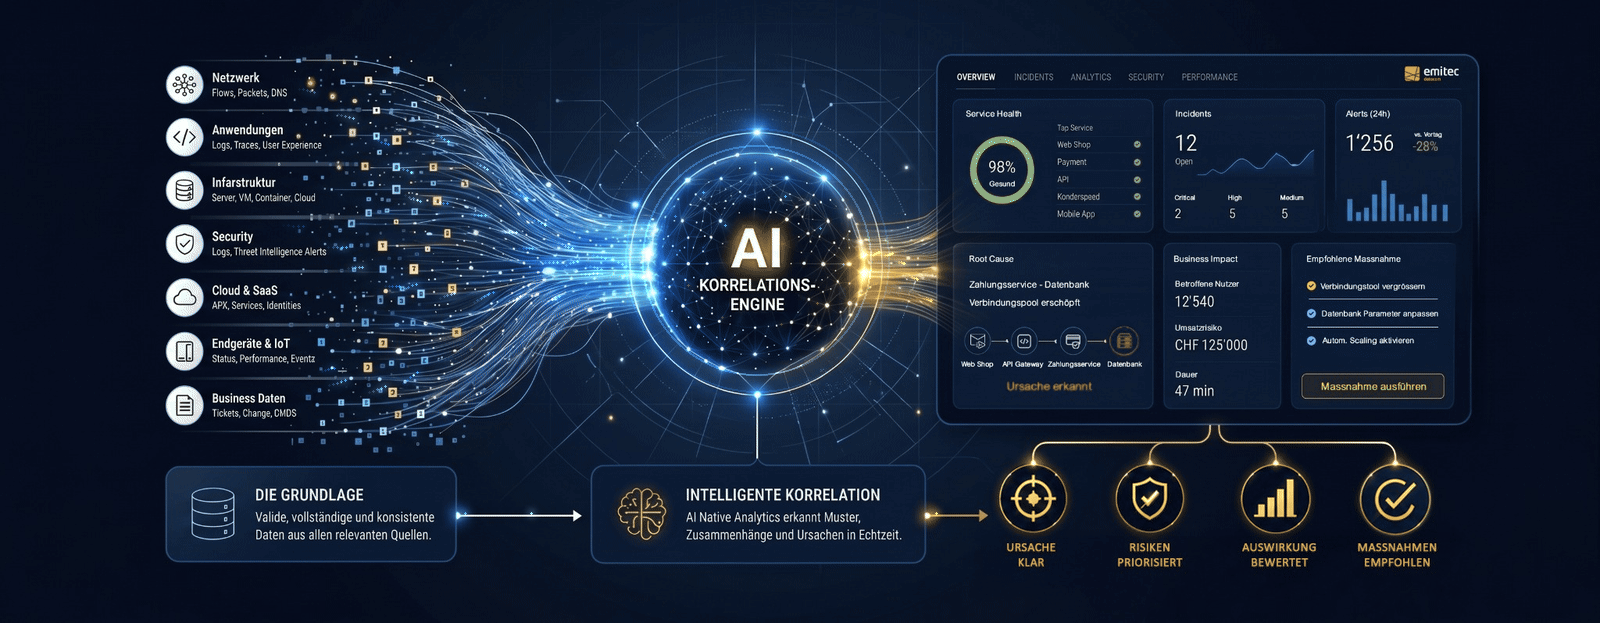
Als technologische Basis für AI Native Operations setzt Emitec auf Selector AI, eine AIOps-Plattform für Telemetrie-Korrelation, Unified Observability, Ursachenanalyse und Predictive Operations. Herstellerseitig verbindet sie Logs, Metriken, Konfigurationen und Topologien in einem gemeinsamen Modell und ergänzt das um Digital Twin, Copilot und eine Action Layer und liefert damit das technologische Fundament, um ein AI-Native-Operations-Betriebsmodell operativ umzusetzen. Welche dieser Funktionen, Integrationen und Autonomiegrade für ein konkretes Projekt tatsächlich sinnvoll sind, klärt sich im jeweiligen Scope. Die Einführung eines AI-Native-Operations-Modells gelingt nicht durch die reine Beschaffung von Lizenzen. Emitec verantwortet die technische und prozessuale Integration über die gesamte Wirkungskette:
Definition des konkreten Ziel-Use-Cases, Überprüfung der Telemetrie-Coverage und Design belastbarer Datenpipelines (inkl. TAPs und Packet Broker).
Aufbau einer Testumgebung gegen eine zuvor definierte Baseline (z.B. MTTA/MTTR-Reduktion), um den Nutzen vor einem Rollout messbar zu belegen. .
Anbindung der Datenquellen, Normalisierung der Telemetrie sowie das essenzielle Aufsetzen der Entity Resolution für den Topologie-Kontext.
Abstimmung der Automatisierungs-Playbooks, Definition der Autonomiegrade und Begleitung beim Übergang in den produktiven ITSM-Workflow.

Selector AI analysiert Milliarden von Telemetrie-Daten in Echtzeit, erkennt Root Causes automatisch und beschleunigt die Fehlerbehebung mit intelligenter AIOps.
AI Native Operations macht daraus ein kontextreiches, integriertes und kontrolliert automatisiertes Betriebsmodell.
Monitoring beantwortet Fragen, die man schon kennt – anhand fester Messgrössen und Schwellenwerte. Observability geht weiter. Reichhaltige Telemetrie und Kontext erlauben es, auch unbekannte Zustände zu untersuchen. AIOps setzt an dieser Stelle Statistik, Machine Learning und Automation ein, um Ereignisse zu bündeln, Muster zu erkennen, Incidents zu priorisieren und nächste Schritte vorzuschlagen.
AI Native Operations reiht sich nicht als weitere Funktion in diese Kette ein, sondern verändert das Betriebsmodell von Grund auf. Die KI prägt hier Architektur und Arbeitsablauf. Dazu gehören ein kontextreiches Datenmodell, Korrelation über Domänengrenzen hinweg, nachvollziehbare Hypothesen, integrierte Aktionen und eine Governance, die den Autonomiegrad klar begrenzt.
|
Ansatz |
Schwerpunkt |
Operative Konsequenz |
|
Monitoring |
überwacht bekannte Zustände anhand fester Messgrössen und Schwellenwerte |
Teams werten Dashboards und Meldungen grösstenteils von Hand aus |
|
AIOps |
wertet Operations-Daten mit Statistik, Machine Learning und Automation aus |
Events werden gebündelt, korreliert, priorisiert und angereichert |
|
AI Native Operations |
KI prägt Datenmodell, Kontext, Diagnose und kontrollierte Aktionen |
Hypothesen sind evidenzbasiert, Workflows integriert, Autonomiegrade klar definiert |
Grenze des Ansatzes
Ein Chatbot obendrauf, eine generative Zusammenfassung oder eine zusätzliche Anomalieerkennung machen aus einer bestehenden Monitoring-Plattform noch keine Plattform für AI Native Operations.
Der Begriff AIOps wurde 2016 von Gartner geprägt. Als Antwort auf ein Problem, das viele IT-Abteilungen bis heute kennen. Mit der digitalen Transformation wuchs die Menge an Betriebsdaten schneller, als klassische, regelbasierte Monitoring-Tools sie verarbeiten konnten. Feste Schwellenwerte wie „Warnung ab 90 % CPU-Auslastung" erzeugten mit steigender Systemkomplexität immer mehr Fehlalarme, während echte Probleme im Rauschen untergingen. Dieser Effekt ist als Alert Fatigue bekannt.
AIOps begegnet diesem Problem, indem es Big Data, Analytik und maschinelles Lernen kombiniert: Daten aus Logs, Metriken, Events, Tickets und Topologien werden automatisch gesammelt, korreliert und interpretiert. Der Unterschied zu älteren Techniken liegt darin, dass das System nicht nur meldet, sondern lernt. Muster aus der Vergangenheit werden erkannt, Zusammenhänge zwischen unabhängig erscheinenden Ereignissen werden sichtbar, und aus tausenden Einzelmeldungen wird eine überschaubare Zahl priorisierter, kontextualisierter Erkenntnisse. Genau diese Fähigkeiten bilden das technische Fundament, auf dem AI Native Operations aufbaut.
In der Praxis wird AIOps häufig mit verwandten Begriffen verwechselt, die jeweils eine andere Phase im IT-Lebenszyklus adressieren:
|
Konzept |
Fokus |
Ziel |
|
ITOps |
klassischer, oft manueller IT-Betrieb: Server, Netzwerke, Anwendungen am Laufen halten |
Stabilität durch menschliche Überwachung und feste Prozesse |
|
DevOps |
Zusammenarbeit von Entwicklung und Betrieb, kontinuierliche Integration/Bereitstellung (CI/CD) |
Schnellere, häufigere und zuverlässigere Software-Releases |
|
MLOps |
Entwicklung, Bereitstellung und Verwaltung von Machine-Learning-Modellen selbst |
Zuverlässiger Betrieb von KI-/ML-Anwendungen |
|
AIOps |
Einsatz von KI/ML, um den IT-Betrieb (ITOps) zu automatisieren und zu optimieren |
Schnellere Fehlerbehebung, weniger manueller Aufwand, proaktives Management |
Vereinfacht: ITOps ist die klassische Disziplin, die AIOps modernisiert. DevOps bestimmt, wie Software entsteht und ausgeliefert wird, AIOps dagegen, wie die daraus entstehende Infrastruktur im laufenden Betrieb überwacht und repariert wird. MLOps wiederum sorgt dafür, dass die KI-Modelle, die auch in AIOps- und in AI-Native-Operations-Plattformen zum Einsatz kommen, selbst zuverlässig laufen. AI Native Operations baut auf all dem auf, geht aber einen entscheidenden Schritt weiter. Die KI prägt hier nicht nur einzelne Funktionen, sondern das gesamte Betriebsmodell.
1. Daten aus relevanten Domänen erfassen
Metriken, Logs und Events allein reichen bei den meisten Enterprise-Use-Cases nicht aus. Erst Netzwerkpakete, Flows, Konfigurationen, Topologien, Abhängigkeiten, Tickets, synthetische Tests und Service-Kontext ergeben ein vollständiges Lagebild. Wichtiger als die Zahl der angebundenen Quellen sind dabei Coverage, Zeitbezug, Datenqualität und Kosten.
2. Technischen und betrieblichen Kontext aufbauen
Über Entity Resolution und ein sich laufend aktualisierendes Topologiemodell wird sichtbar, welche Komponenten zu welchem Service gehören und wie sich eine Änderung oder ein Ausfall fortpflanzt. Fehlt dieser Kontext, bleibt jede Korrelation oberflächlich – und eine belastbare Ursachenanalyse ist kaum zu leisten.
3. Muster, Zusammenhänge und Auswirkungen einordnen
Machine Learning, statistische Verfahren und domänenspezifische Modelle filtern Duplikate heraus, erkennen Abweichungen und bringen Ereignisse in eine Reihenfolge. Entscheidend ist, dass sichtbar bleibt, welche Daten und Abhängigkeiten eine Hypothese stützen – denn Korrelation belegt noch keine Kausalität.
4. Entscheidungen und Aktionen in bestehende Workflows überführen
Die gewonnenen Erkenntnisse fliessen in ITSM-, Collaboration- oder Automatisierungsplattformen ein. Der Autonomiegrad variiert je nach Use Case: von der assistiven Suche über Empfehlungen bis zu freigegebenen Playbooks oder eng begrenzten, autonomen Aktionen innerhalb fest definierter Policies.
5. Resultate verifizieren und zurückführen
Nach jeder Aktion steht die Kontrolle: Hat der Service wieder den erwarteten Zustand erreicht? Erfolgsquote, Fehlaktionen, Rollbacks und manuelle Eingriffe fliessen als Feedback in Modelle, Regeln und Runbooks zurück. Erst dieser Rückkopplungsschritt macht aus reiner Automation einen kontrollierten Betriebsprozess für AI Native Operations.
In der Praxis scheitern Initiativen am häufigsten beim Aufbau des technischen Kontextes (Schritt 2), konkret an einer fehlenden oder veralteten Topologie-Map und unsauberen CMDB-Daten. Die Telemetrie an sich ist in den meisten Enterprise-Umgebungen ausreichend vorhanden. Ein typisches Praxisbeispiel verdeutlicht das: Bei einem kritischen Netzwerk-Vorfall meldete das Monitoring zwar zuverlässig einen Paketverlust an einem Core-Switch, aber mangels sauberer Switch-Server-Zuordnung (Entity Resolution) konnte die KI nicht ableiten, welche Applikations-Gateways davon betroffen waren. Die Meldung blieb ohne Service-Kontext wertlos. Erst als die Topologie-Daten normalisiert und verknüpft wurden, konnte das System verwertbare Ursachenhypothesen bilden.
Die KI allein erzeugt noch keinen Mehrwert. Dieser entsteht erst aus dem Zusammenspiel von Daten, Kontext, Entscheidungslogik und kontrollierten Aktionen und lässt sich nur gegen eine Ausgangsbasis und anhand konkreter Betriebskennzahlen wirklich belegen.
|
Mehrwert |
Wie er entsteht |
Wie er gemessen werden kann |
|
Zeitersparnis |
weniger manuelle Suche und Übergaben dank Korrelation, Kontext und Incident Enrichment |
MTTA, MTTR, Mean Time to Innocence, Analysezeit pro Incident |
|
Mehr Funktionalität |
gemeinsames Datenmodell, Topologie, Copilot-Zugriff, Predictive Insights und integrierte Aktionen erweitern den Handlungsspielraum |
abgedeckte Use Cases, integrierte Quellen, Automatisierungsquote, Erfolgsquote |
|
Höhere Betriebsqualität |
dynamische Baselines und eine domänenübergreifende Sicht schärfen Priorisierung und Diagnose |
Alert-to-Incident Ratio, Eskalationsquote, wiederkehrende Incidents, SLO-Erfüllung |
|
Entlastete Fachkräfte |
repetitive Triage-, Such- und Dokumentationsschritte werden unterstützt oder übernommen |
manuelle Schritte pro Incident, Toil, Bereitschaftsaufwand, Zeit für Verbesserungsarbeit |
|
Stabilere Services |
schleichende Verschlechterungen zeigen sich früher im Servicekontext |
Verfügbarkeit, Error Budget Burn Rate, Nutzererfahrung, störungsbedingte Unterbrüche |
|
Wirtschaftlichkeit |
Tools und Workflows lassen sich konsolidieren, Betriebsaufwände sinken |
TCO, Toolkosten, Datenkosten, Implementierungsaufwand, vermiedener Aufwand |
Ein grosser Teil der Zeit bei komplexen Incidents geht schlicht fürs Zusammentragen von Informationen drauf: zwischen Dashboards wechseln, Zeitachsen vergleichen, Abhängigkeiten prüfen, Zuständigkeiten klären. Eine Plattform für AI Native Operations nimmt Teams genau diese Schritte ab. Sie bündelt zusammengehörige Signale, bestimmt betroffene Services, ordnet relevante Änderungen zu und liefert den Incident direkt mit Kontext.
Der Effekt zeigt sich deshalb nicht nur bei der MTTR. Auch MTTA, Mean Time to Innocence und der manuelle Analyseaufwand pro Incident können spürbar sinken. Wie stark, hängt von Datenqualität, Integrationsgrad, Use Case und Betriebsreife ab – ein Pauschalversprechen wäre hier unseriös.
AI Native Operations erweitert, was Teams tun können. Ein gemeinsames Daten- und Topologiemodell macht domänenübergreifende Abfragen, Impact-Analysen, Predictive Insights und kontextbezogene Handlungsempfehlungen erst möglich. Copilot-Funktionen erleichtern Fachpersonen den Zugriff auf komplexe Daten, ersetzen aber weder die technische Validierung noch klare Berechtigungen.
Diesen Mehrwert gibt es allerdings nur, wenn die neue Funktionalität in bestehende Prozesse eingebettet wird. Eine zusätzliche Oberfläche ohne Anbindung an ITSM, CMDB, Collaboration und Automation schafft am Ende mehr Komplexität, statt sie zu reduzieren.
Erfahrene Fachpersonen erkennen Zusammenhänge oft im Kopf schneller als jedes isolierte Tool. Nur lässt sich dieses Wissen kaum skalieren, und bei Schichtwechseln oder wenn jemand das Unternehmen verlässt, ist es plötzlich weg. Kontextbezogene Modelle, dokumentierte Hypothesen und wiederverwendbare Runbooks machen einen Teil dieses Wissens für das ganze Team nutzbar – und genau das macht Entscheidungen bei AI Native Operations konsistenter und nachvollziehbarer.
Reduktion der Analysezeit durch domänenübergreifende Korrelation:
Ausgangslage:
Sporadischer Paketverlust
führte regelmässig zu Performance-Einbussen einer geschäftskritischen
Web-Applikation.
Datenquellen:
Netzwerk-Flows,
Applikations-Logs, Router-Metriken und Firewall-Events.
Bisherige manuelle Schritte:
Das Operations-Team musste
Logs aus vier verschiedenen Tools manuell exportieren, zeitlich abgleichen
und Abhängigkeiten prüfen, um den Fehler einzugrenzen. Die Baseline für
die Mean Time to Acknowledge (MTTA) lag bei 45 Minuten pro
Incident.
Unterstützte Schritte durch AI
Native Operations:
Die Signale aus Netzwerk und Applikation wurden
domänenübergreifend auf einer gemeinsamen Zeitachse korreliert. Statt
unzähliger isolierter Einzelwarnungen generierte das System einen
einzigen, kontextualisierten Incident, der direkt das betroffene Applikations-Gateway
als wahrscheinliche Ursache auswies.
Gemessene
Veränderung:
Die Triage-Zeit sank von 45 Minuten auf unter 3 Minuten (Messzeitraum:
3 Monate, Scope: Core Network & App-Gateways).
Domänenübergreifende Incident-Triage:
Signale aus Netzwerk, Infrastruktur, Cloud und Anwendungen laufen auf einer gemeinsamen Zeitachse und im Servicekontext zusammen. Wer zuständig ist, lässt sich so schneller klären – unnötige Eskalationen entfallen.
Priorisierte Ursachenhypothesen:
Statt einzelner Symptome bekommen Teams eine begründete Rangfolge möglicher Ursachen, wobei die zugrunde liegenden Signale und Abhängigkeiten für die fachliche Prüfung nachvollziehbar bleiben.
Automatisiertes Incident Enrichment:
Tickets werden automatisch mit betroffenen Services, relevanten Ereignissen, Topologie, früheren Änderungen und empfohlenen Prüfschritten angereichert – manuelle Erfassung und Rückfragen fallen weitgehend weg.
Predictive Operations und Kapazitätsplanung:
Wiederkehrende Muster und schleichende Verschlechterungen werden früher erkennbar, sodass Teams reagieren können, bevor Kapazitätsgrenzen oder Serviceeinschränkungen tatsächlich eintreten.
Change- und Impact-Analyse:
Ein aktuelles Abhängigkeitsmodell zeigt, welche Services, Standorte oder Nutzergruppen von einer geplanten Änderung betroffen sein könnten – die tatsächliche Wirkung wird danach verifiziert.
Service Assurance und Nutzererfahrung:
Wenn technische Telemetrie mit SLI, SLO, synthetischen Tests oder End-User-Experience-Daten verknüpft wird, lässt sich klar priorisieren, welche technische Abweichung tatsächlich einen relevanten Service beeinträchtigt.
Operations und Security greifen teilweise auf dieselben Datenquellen, Topologien und Automatisierungsmechanismen zu. Ihre Entscheidungslogik unterscheidet sich trotzdem grundlegend. IT Operations zielt auf Verfügbarkeit, Performance, Servicequalität und Wiederherstellungszeit. Bei SecOps geht es um weniger Angriffsfläche, das Erkennen bösartiger Aktivität, die Eindämmung von Auswirkungen und die Wiederherstellung von Vertrauenswürdigkeit.
Eine ungewöhnliche Datenrate kann genauso gut ein Kapazitätsengpass, eine Fehlkonfiguration oder legitime Nutzung sein wie ein Angriff. Deshalb darf AIOps eine Anomalie nicht automatisch als Sicherheitsvorfall werten. Der eigentliche Mehrwert liegt im gemeinsamen Kontext und in klar definierten Übergaben an SIEM, SOAR, EDR, NDR oder XDR – nicht darin, diese Systeme zu ersetzen.
Betriebliche Konsequenz
Gemeinsame Datenpipelines und Case-Informationen können Doppelarbeit vermeiden. Rollen, Zugriffsrechte, Beweissicherug, Eskalationen und Freigaben für die Response müssen für Operations und Security dennoch getrennt geregelt bleiben.
Betriebsverantwortung: Rollen, Runbooks, Eskalationswege,
Modellüberwachung und kontinuierliche Verbesserung brauchen einen festen
organisatorischen Platz.
Emitec bringt die Perspektiven von IT Operations, Observability, Netzwerk und Security nahtlos zusammen. Der Ausgangspunkt für Ihr Projekt ist dabei immer die ganz konkrete Betriebsherausforderung und die exakt dafür nötige Datenbasis im Unternehmen – nicht einfach nur eine isolierte Produktfunktion. Durch diesen ganzheitlichen Blickwinkel stellen wir sicher, dass technologische Silos aufgebrochen werden und echte Mehrwerte für Ihren Betriebsalltag entstehen.
Im ersten Schritt nehmen wir Ihre aktuelle Ausgangslage detailliert auf, identifizieren geschäftskritische Services und definieren klar priorisierte Use Cases.
Daraufhin bewerten wir die in Ihrem Unternehmen bereits vorhandene Telemetrie, bestehende Datenpipelines, Topologien und aktuelle Integrationen.
Basierend auf den gewonnenen Erkenntnissen ordnen wir eine passende Lösungsarchitektur und die idealen Plattformfunktionen genau Ihren spezifischen Anforderungen zu.
Um den tatsächlichen Mehrwert zu belegen, testen wir den Nutzen und auch die Grenzen der Lösung in einem Proof of Value gegen eine vorab definierte Baseline.
Wir binden die neuen Systeme direkt an Ihre bestehenden ITSM- und Operations-Workflows an, definieren klare Verantwortlichkeiten (Rollen) und legen verbindliche Automatisierungsgrenzen fest.
Abschliessend bauen wir relevante Messgrössen, ein zukunftsfähiges Betriebsmodell und strukturierte Prozesse für die laufende Optimierung auf.
Zu AI-Native IT Operations
Das kommt auf den Use Case an. Metriken, Logs und Events bilden meist die Basis. Für eine belastbare Korrelation kommen oft noch Netzwerkpakete, Flows, Konfigurationen, Topologie, Service-Abhängigkeiten, Tickets und synthetische Messungen dazu. Ausschlaggebend ist, wie vollständig der kritische Servicepfad abgedeckt ist.
Nicht unbedingt. Bestehende Systeme können weiterhin als Datenquelle, System of Record oder System of Action dienen. Ob und welche Werkzeuge sich konsolidieren lassen, zeigt erst die Prüfung von Funktionsabdeckung, Datenqualität, Integrationen, Kosten und möglichen blinden Flecken.
Das wird pro Use Case festgelegt. Unkritische, reversible Schritte lassen sich innerhalb klar definierter Policies automatisieren. Bei risikoreichen Änderungen braucht es dagegen Freigaben, einen Audit Trail, Abbruchbedingungen und einen getesteten Rollback.
Baseline, Scope, Zeitraum und Erfolgskriterien stehen schon vor dem Test fest. Je nach Use Case eignen sich dafür MTTA, MTTR, Mean Time to Innocence, Alert-to-Incident Ratio, Automatisierungsquote, manuelle Analysezeit, SLO-Erfüllung oder Nutzererfahrung.
Dazu gehören Datenstandort, Zugriffsrechte, Modellzugriff, Protokollierung, Aufbewahrungsfristen, Freigaben, Fehlertoleranz, Rollback, Verantwortlichkeiten und Abhängigkeiten von Lieferanten. Fragen, die in die Architektur- und Betriebsentscheidung gehören.
CEO | Senior Consultant
+41 41 748 60 10
Entdecken Sie unsere gefragtesten Themen – mit einem Klick.
AI-Native SecOps erkennt Bedrohungen proaktiv und unterstützt Security-Teams mit intelligenter Automatisierung. So werden Risiken schneller und effizienter reduziert.
Unternehmen sammeln grosse Mengen an Netzwerkdaten. TAPs überwachen den Verkehr, und Packet-Broker filtern und bündeln die Daten. Dies part Kosten und verbessert die Datenerhebung.
Die Stabilität von Anwendungen beeinflusst die Produktivität. EUEM identifiziert frühzeitig Probleme und hilft, die Qualität der Anwendungen zu sichern.
Eine zuverlässige Lösung zur Überwachung der Verfügbarkeit von Applikationen und Services reduziert den Workload und schafft Kapazitäten für strategische IT-Projekte.